 ## Teoria

library(xml2)

# Ler o HTML
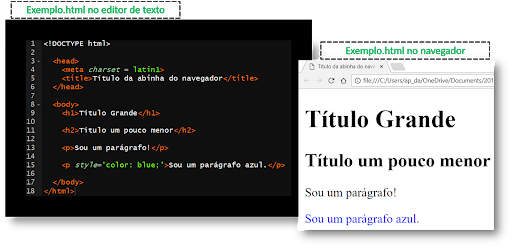
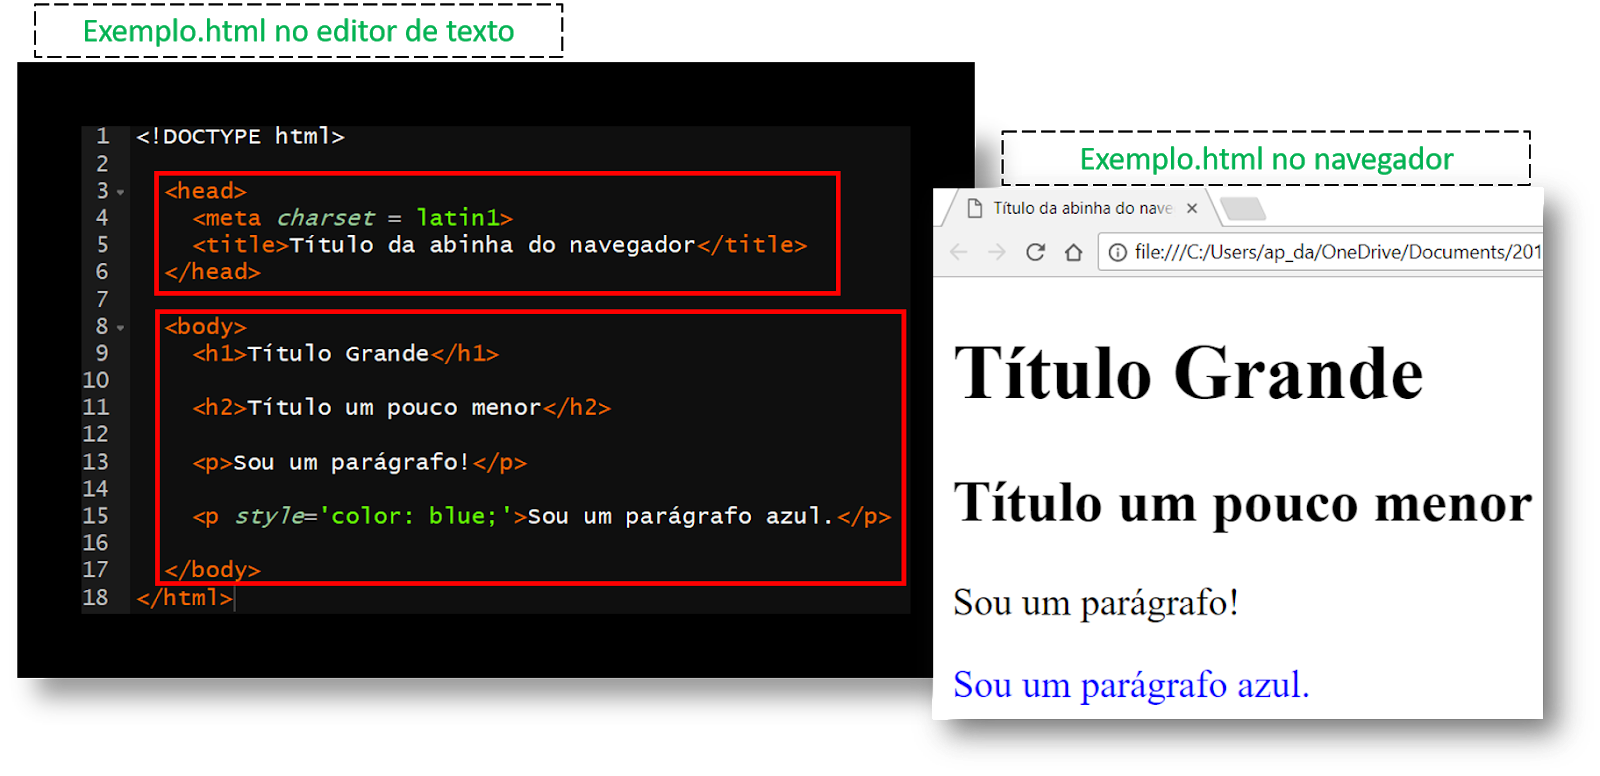
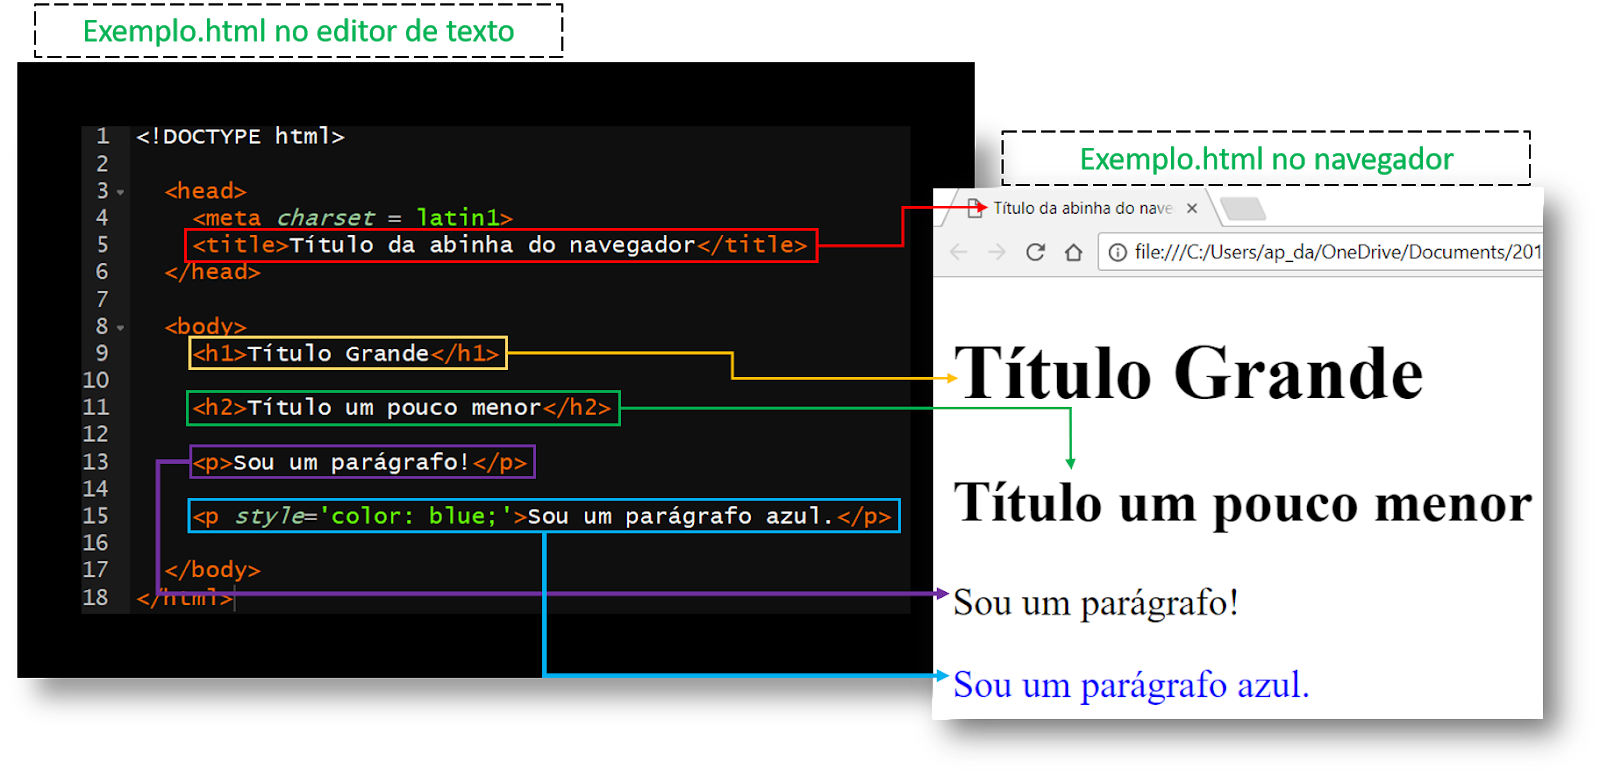
html <- read_html("img/html_exemplo.html")

# Coletar todos os nodes com a tag <p>
nodes <- xml_find_all(html, "//p")

# Extrair o texto contido em cada um dos nodes
text <- xml_text(nodes)
text
[1] "Sou um parágrafo!" "Sou um parágrafo azul."
